
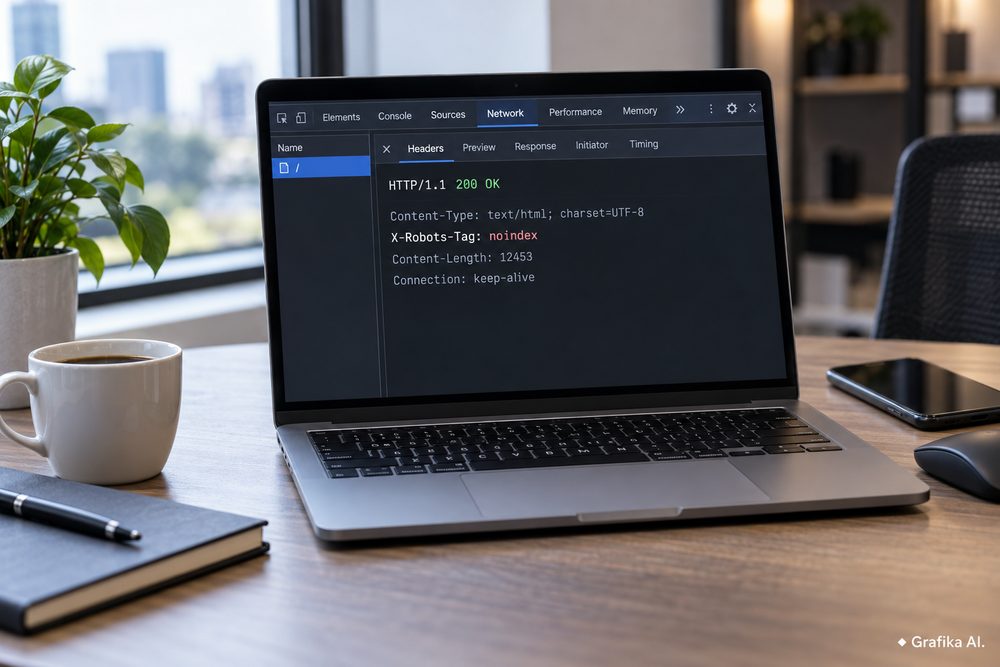
Strona działa, zwraca kod HTTP 200, a w jej źródle nie ma znacznika <meta name="robots" content="noindex">. Mimo to Google Search Console pokazuje komunikat „Wykluczono na podstawie tagu noindex”. Przyczyną może być X-Robots-Tag, czyli dyrektywa indeksowania przesyłana w nagłówku odpowiedzi HTTP, a nie w kodzie HTML. Nie zobaczymy jej przez zwykłe „Wyświetl źródło strony”. Trzeba sprawdzić odpowiedź serwera, najlepiej dla dokładnego adresu URL zgłaszanego przez Google.
X-Robots-Tag – dlaczego blokuje indeksowanie bez widocznego noindex?
X-Robots-Tag przekazuje robotom wyszukiwarek instrukcje dotyczące indeksowania i prezentowania zasobów w wynikach wyszukiwania. Działa na poziomie odpowiedzi HTTP, dlatego może obejmować zarówno strony HTML, jak i dokumenty PDF, obrazy czy inne pliki. To istotna różnica względem klasycznego znacznika meta robots, umieszczanego w dokumencie HTML.
Serwer może zwrócić następującą odpowiedź:
HTTP/2 200
content-type: text/html; charset=UTF-8
x-robots-tag: noindex, follow
Kod 200 OK oznacza prawidłową odpowiedź serwera, ale nie gwarantuje dopuszczenia strony do indeksu. Dyrektywa noindex nakazuje obsługującej ją wyszukiwarce wykluczyć adres z wyników. Z kolei follow nie znosi tego ograniczenia – dotyczy wyłącznie podążania za linkami.
Najczęściej spotykane dyrektywy to:
- noindex – zabrania wyświetlania danego zasobu w wynikach wyszukiwania.
- nofollow – instruuje robota, aby nie podążał za linkami znajdującymi się na stronie.
- none – odpowiednik połączenia
noindex, nofollow. - noarchive – historyczna dyrektywa dotycząca kopii strony; Google nie udostępnia już funkcji stron zapisanych w pamięci podręcznej, więc nie należy traktować jej jako użytecznego sposobu zarządzania indeksacją.
- googlebot: noindex – ogranicza dyrektywę do robota Google, zamiast kierować ją do wszystkich crawlerów.
W praktyce problem pojawia się często po przeniesieniu sklepu z serwera testowego na produkcyjny. Administrator wcześniej ustawia globalny nagłówek X-Robots-Tag: noindex, aby środowisko testowe nie trafiało do Google. Po migracji kopiuje konfigurację Apache lub Nginx, razem z niechcianą regułą. Sklep działa prawidłowo, produkty są dostępne, a indeksacja pozostaje zablokowana.
Szczególnie niebezpieczna jest reguła globalna, obejmująca wszystkie odpowiedzi serwera. Jedna linia w konfiguracji potrafi wykluczyć tysiące adresów, także kategorii i produktów generujących sprzedaż.
Nie oznacza to jednak, że każdy X-Robots-Tag należy usuwać. Nagłówek z noindex ma uzasadnienie przy wybranych zasobach, na przykład dokumentach PDF przeznaczonych do udostępniania bezpośrednim linkiem, które nie powinny samodzielnie pojawiać się w wynikach Google. Jeśli jednak PDF zawiera unikalną instrukcję, katalog produktów lub wartościową publikację, blokowanie jego indeksowania może pozbawić witrynę dodatkowego ruchu.
Decyzję trzeba więc podejmować na poziomie rodzaju zasobu i jego funkcji w wyszukiwarce, a nie samej obecności nagłówka.
Jak sprawdzić X-Robots-Tag za pomocą curl, przeglądarki i Google Search Console?
Najszybszą metodą jest sprawdzenie nagłówków HTTP. W terminalu systemu Linux, macOS albo Windows z dostępnym narzędziem curl wystarczy wykonać:
curl -I https://example.com/oferta/Parametr -I pobiera nagłówki odpowiedzi na żądanie HEAD, bez treści dokumentu. W wyniku należy szukać x-robots-tag. Wielkość liter w nazwie nagłówka nie ma znaczenia.
Przykładowy wynik:
HTTP/2 200
server: nginx
content-type: text/html
x-robots-tag: noindex
Jeżeli nagłówek występuje, mamy konkretną przyczynę blokady dla robotów respektujących tę dyrektywę.
Samo curl -I nie wystarcza jednak do zamknięcia diagnostyki. Niektóre serwery, aplikacje i warstwy pośredniczące inaczej obsługują żądania HEAD oraz GET. Warto sprawdzić odpowiedź GET i zapisać jej nagłówki:
curl -sS -D - -o /dev/null \
https://example.com/oferta/
Druga pułapka to przekierowania. Adres bez ukośnika może zwracać 301, a docelowa wersja 200 z innymi nagłówkami. Wtedy przydaje się:
curl -sS -L -D - -o /dev/null \
https://example.com/oferta
Opcja -L pozwala przejść przez przekierowania. Trzeba przeanalizować kolejne odpowiedzi, a przede wszystkim nagłówek końcowego dokumentu, który Google ma indeksować.
Do porównania odpowiedzi kierowanej do Googlebota można użyć:
curl -sS -D - -o /dev/null \
-A "Googlebot" \
https://example.com/oferta/
Zmiana User-Agent pomaga wykryć reguły zależne od deklarowanej nazwy robota. Nie dowodzi jednak, że rzeczywisty Googlebot otrzymuje identyczną odpowiedź, ponieważ serwer może weryfikować także adres IP lub inne parametry żądania.
Osoby bez dostępu do terminala mogą przeprowadzić kontrolę w Chrome:
- Otworzyć badaną stronę i nacisnąć
F12. - Przejść do zakładki Network (Sieć).
- Odświeżyć stronę, aby zarejestrować żądania.
- Wybrać główne żądanie dokumentu, a nie plik CSS czy JavaScript.
- Otworzyć Headers → Response Headers i znaleźć
x-robots-tag.
Warto również skorzystać z Google Search Console. W narzędziu „Sprawdzenie adresu URL” należy zweryfikować datę ostatniego skanowania, dostępność strony dla robota i informację „Indeksowanie dozwolone?”. Następnie uruchomić test adresu URL na żywo.
Przykład: właściciel sklepu usunął blokadę trzy dni temu, ale Search Console nadal zgłasza wykluczenie. Jeżeli ostatnie skanowanie odbyło się przed poprawką, raport może przedstawiać wcześniejszy stan. Test na żywo pomaga potwierdzić, czy Google widzi już aktualną wersję strony.
Trzeba też odróżnić blokadę noindex od problemów z robots.txt. Dyrektywa Disallow ogranicza skanowanie, ale nie jest równoważna noindex. Co więcej, jeśli Googlebot nie może pobrać strony z powodu robots.txt, nie odczyta również jej nagłówka X-Robots-Tag. Dlatego dodawanie Disallow jako sposobu naprawy błędnej indeksacji jest złym kierunkiem.
Jeżeli w odpowiedzi nie ma noindex, a Google nadal nie indeksuje adresu, należy przejść do innych przyczyn: znacznika meta robots, przekierowań, błędów dostępu, kanonikalizacji albo oceny jakości i duplikacji treści. Brak nagłówka blokującego nie jest obietnicą indeksacji.
Jak usunąć błędny nagłówek i nie zablokować całej witryny?
Po potwierdzeniu problemu trzeba znaleźć miejsce, w którym powstaje nagłówek. X-Robots-Tag nie musi pochodzić z CMS-a. Może być dodawany przez serwer HTTP, kod aplikacji, reverse proxy, CDN albo regułę bezpieczeństwa.
Na serwerach Apache pierwszym miejscem kontroli jest konfiguracja VirtualHost oraz pliki .htaccess. Przykładowa reguła wymuszająca blokadę wygląda następująco:
Header set X-Robots-Tag "noindex"Jeżeli została ustawiona globalnie i nie jest potrzebna, należy usunąć ją z właściwego pliku konfiguracyjnego. Nie należy natomiast dopisywać w przypadkowym miejscu drugiego nagłówka index, licząc na nadpisanie blokady. Google stosuje bardziej restrykcyjną dyrektywę, gdy równocześnie otrzymuje sprzeczne instrukcje indeksowania.
Na serwerach Nginx analogiczny zapis wygląda tak:
add_header X-Robots-Tag "noindex";W obu przypadkach zmiana wymaga sprawdzenia zakresu reguły oraz tego, czy konfiguracja nie jest generowana przez panel hostingowy. Przy Nginx znaczenie ma również dziedziczenie dyrektyw add_header między blokami konfiguracji. Prosta zmiana w jednym location nie zawsze daje oczekiwany wynik.
Przed przeładowaniem Nginx należy sprawdzić składnię:
nginx -tDopiero po pozytywnym wyniku można przeładować konfigurację zgodnie z procedurą danego serwera.
W środowisku WordPress warto zacząć od ustawień widoczności witryny, wtyczek SEO oraz konfiguracji serwera. Samo odznaczenie opcji zniechęcającej wyszukiwarki do indeksowania nie rozwiąże problemu, jeżeli nagłówek jest wymuszany poza WordPressem.
Osobnej uwagi wymaga Cloudflare i inne usługi CDN. Reguła modyfikująca nagłówki odpowiedzi może działać niezależnie od serwera źródłowego. Jeżeli nagłówek pojawia się wyłącznie w odpowiedzi publicznej, a nie występuje podczas kontrolowanego testu originu, należy sprawdzić konfigurację warstwy pośredniczącej. Po zmianach trzeba ponownie zbadać odpowiedź publicznego adresu, uwzględniając ewentualne różnice między lokalizacjami CDN.
Dobrym przykładem jest sklep, w którym indeksowanie kategorii powinno być dozwolone, ale część automatycznie generowanych plików PDF ma pozostać poza wynikami Google. Usunięcie globalnego noindex jest wtedy zasadne, natomiast dla wybranych dokumentów można zachować regułę ograniczoną do konkretnej ścieżki lub typu pliku.
Taki podział jest bezpieczniejszy niż wyłączanie wszystkich nagłówków sterujących robotami. Jednocześnie trzeba sprawdzić, czy po zawężeniu reguły istotne dokumenty nie zostały przypadkowo objęte blokadą.
W przypadku większych serwisów, zwłaszcza sklepów z tysiącami adresów, rozsądna kolejność działania wygląda następująco:
- Priorytet 1: usunięcie niezamierzonego
noindexz ważnych stron kategorii, produktów i stron ofertowych. - Priorytet 2: kontrola reguł dla szablonów, wersji językowych, subdomen oraz dokumentów.
- Priorytet 3: ponowny test nagłówków, weryfikacja w Search Console i monitorowanie raportu indeksowania.
Do kontroli większej liczby URL-i można wykorzystać Screaming Frog SEO Spider, który pozwala analizować nagłówki i dyrektywy robots. Przy serwisach zawierających kilkadziesiąt tysięcy podstron ręczne sprawdzanie pojedynczych adresów jest mało praktyczne. Trzeba jednak uwzględnić ustawienia renderowania, limity narzędzia i fakt, że bot audytowy nie zawsze otrzymuje identyczną odpowiedź jak Googlebot.
Po naprawie można zgłosić ważne adresy do ponownego zindeksowania w Google Search Console. Nie oznacza to natychmiastowego powrotu do wyników. Google musi ponownie odwiedzić stronę, przetworzyć jej zawartość i podjąć decyzję o indeksowaniu. Dla części adresów nastąpi to szybko, dla innych oczekiwanie może trwać tygodnie, a nawet dłużej.
Przy diagnozowaniu problemów technicznych SEO pomocne jest oddzielenie błędów konfiguracji od decyzji wyszukiwarki o wyborze stron do indeksu. Dodatkowe materiały dotyczące marketingu internetowego i pozycjonowania można znaleźć również w serwisach branżowych, ale ostateczną ocenę błędu należy oprzeć na rzeczywistej odpowiedzi serwera i danych z Search Console.
FAQ – najczęstsze pytania o X-Robots-Tag
Czy X-Robots-Tag jest widoczny w kodzie źródłowym strony?
Nie. To nagłówek odpowiedzi HTTP, który należy sprawdzić w narzędziach deweloperskich przeglądarki, przez curl albo narzędzie analizujące odpowiedzi serwera.
Czy X-Robots-Tag: noindex blokuje Google, nawet jeśli meta robots ma wartość index?
Tak. Google respektuje bardziej restrykcyjną dyrektywę. Deklaracja index w HTML nie neutralizuje nagłówka noindex.
Czy kod HTTP 200 oznacza, że strona może zostać zaindeksowana?
Nie. Odpowiedź 200 potwierdza poprawne udostępnienie zasobu, ale strona nadal może zawierać instrukcję blokującą indeksację.
Czy X-Robots-Tag działa na dokumenty PDF?
Tak. To jedna z podstawowych metod kontrolowania indeksowania plików, których nie można wyposażyć w klasyczny znacznik meta robots HTML.
Czy usunięcie X-Robots-Tag gwarantuje indeksację?
Nie. Usuwa konkretną przeszkodę techniczną. Google nadal bierze pod uwagę dostępność adresu, kanonikalizację, zawartość strony i inne sygnały.
Jak długo trwa aktualizacja indeksu po usunięciu noindex?
Nie ma stałego terminu. Zmiana może zostać uwzględniona przy kolejnym skanowaniu, ale ponowne przetworzenie adresu może potrwać od kilku dni do wielu tygodni, a w niektórych przypadkach dłużej.
Czy robots.txt może zastąpić X-Robots-Tag: noindex?
Nie. robots.txt kontroluje możliwość skanowania, a noindex dotyczy indeksowania. Zablokowanie skanowania może wręcz uniemożliwić Google odczytanie dyrektywy noindex.
Co należy sprawdzić jako pierwsze, gdy Google zgłasza noindex niewidoczny w HTML?
Najpierw wykonaj żądanie GET dla dokładnego adresu URL i sprawdź wszystkie nagłówki odpowiedzi, szczególnie X-Robots-Tag. Jeśli zawiera noindex, ustal, czy dodaje go serwer, aplikacja czy CDN, i usuń niezamierzoną regułę u źródła. Dopiero po potwierdzeniu poprawnej odpowiedzi na publicznym adresie zgłoś stronę do ponownego sprawdzenia w Google Search Console.
Więcej informacji na: https://cmpress.pl


